 המדענית הסגולה | 15 בנובמבר 2026
משתמש סינתטי יכול לחסוך לכם שבוע של הכנה למחקר, ובאותה מידה הוא יכול לשכנע את כל הצוות בממצא שאף אדם אמיתי לא אמר. ההבדל בין שתי האפשרויות לא נמצא בכלי, הוא נמצא בשאלה מה אתם מבקשים ממנו ומה אתם עושים עם התשובות.
אספתי למאמר הזה את המחקרים המפורסמים שהשוו בפועל בין משתמשים סינתטיים לבין אנשים אמיתיים: מאמרים אקדמיים, ניסויים של Nielsen Norman Group ושל MeasuringU, ומחקר שוק מהרווארד. המטרה שלי פשוטה: שתדעו בדיוק מה זה, איפה זה עוזר, איפה זה נשבר, וממה צריך להיזהר לפני שאתם מכניסים את זה לתהליך העבודה שלכם.
מה זה בעצם?
משתמש סינתטי הוא מודל שפה (כמו קלוד או ChatGPT) שמקבל תיאור של אדם, ועונה על שאלות כאילו הוא אותו אדם. נותנים לו פרופיל, למשל "מנהלת מוצר בת 38 שעובדת בחברת פינטק ומזמינה טיסות עבודה פעמיים בחודש", ואז מראיינים אותו כמו שמראיינים משתתפת במחקר.
בפועל יש היום שלוש משפחות של שימוש:
- ראיון פרסונה. שיחה פתוחה עם דמות אחת או כמה, בדיוק כמו ראיון עומק. זה מה שרוב המעצבים מכירים, וזה מה שפלטפורמות כמו Synthetic Users מוכרות.
- "מדגם סיליקון". מאות או אלפי פרופילים שעונים על סקר, כדי לחקות התפלגות של אוכלוסייה. את המונח טבעו Argyle ועמיתיו ב-2023, בכתב העת Political Analysis.
- תאום דיגיטלי. מודל שמקבל את התשובות האמיתיות של אדם מסוים (ראיון ארוך, סקר של מאות שאלות) ומנסה לחזות איך אותו אדם יענה על שאלות חדשות.
שימו לב להבדל שמכריע כמעט את כל מה שבא אחר כך: בשתי המשפחות האחרונות המודל נשען על נתונים של אנשים אמיתיים. בראיון פרסונה רגיל, המודל נשען על מה שהוא "יודע" על אנשים כאלה, כלומר על הממוצע של האינטרנט.
למה כולם מדברים על זה?
כי הכאב אמיתי. גיוס משתתפים לוקח זמן, ראיונות עולים כסף, ולוח הזמנים של ספרינט לא תמיד מחכה. במחקר של Brand, Israeli ו-Ngwe מהרווארד, החוקרים מציינים שמחקר צרכנים מסורתי עולה בדרך כלל מעל 20,000 דולר ולוקח שלושה עד שישה חודשים, בעוד שהמודל החזיר תשובות בפחות מ-15 דקות (HBS Working Knowledge).
הפער הזה הוא בדיוק הסיבה שהנושא נפיץ. מצד אחד, מהירות שאי אפשר להתעלם ממנה. מצד שני, החשש המוצדק של חוקרים שהצוות יפסיק לדבר עם אנשים אמיתיים, כי "יש לנו כבר תשובות".
איפה זה עובד
המחקרים החיוביים מעניינים, אבל צריך לקרוא אותם בעיון, כי הם מצליחים בתנאים מאוד מסוימים.
מגמות ברמת האוכלוסייה
במחקר של Argyle ועמיתיו, המודל קיבל פרופילים דמוגרפיים של משיבים אמיתיים מסקר הבחירות האמריקאי (ANES), והתבקש לחזות את ההצבעה שלהם. המתאם בין ההצבעה ה"סינתטית" לבין ההצבעה המדווחת הגיע ל-0.90 עד 0.94 בשלוש מערכות בחירות. החוקרים עצמם מדגישים שמדובר בהתאמה של דפוסים בקבוצות, לא של אנשים בודדים, ושההתאמה הייתה החלשה ביותר אצל מצביעים עצמאיים.
חיזוי כיוון של אפקט
במחקר שפורסם ב-Nature ב-2026, Ashokkumar, Hewitt, Ghezae ו-Willer הריצו את GPT-4 על 70 ניסויי סקר אמריקאיים, עם 469 אפקטים ו-119,330 משתתפים. החיזויים היו בקורלציה חזקה עם האפקטים האמיתיים, ברמת דיוק דומה לזו של תחזיות משולבות של מומחים. אבל שימו לב לפרט שחשוב לנו: המודל העריך את גודל האפקטים בצורה מוגזמת באופן שיטתי. כלומר הוא ידע לאיזה כיוון, לא כמה.
עיגון בנתונים אמיתיים
Park ועמיתיו מסטנפורד ראיינו 1,052 אמריקאים בראיונות של שעתיים, ובנו מכל ראיון סוכן שמדמה את אותו אדם. הסוכנים שנבנו מהראיונות שיחזרו תשובות לסקר החברתי הכללי ברמה של 83% ביחס לעקביות של האנשים עצמם (כשענו שוב אחרי שבועיים). סוכנים שקיבלו רק נתונים דמוגרפיים הגיעו ל-74%. ההבדל בין שני המספרים האלה הוא, מבחינתי, השיעור הכי חשוב במאמר הזה: ככל שהמודל נשען על מה שאנשים אמיתיים אמרו, הוא פחות ממציא.
מחיר ונכונות לשלם
במחקר של Brand, Israeli ו-Ngwe, הנכונות לשלם על פלואוריד במשחת שיניים יצאה 3.40 דולר אצל המודל, לעומת 3.27 דולר במחקר עם צרכנים אמיתיים. אותו מחקר מצא גם התנהגות שלא תואמת את התיאוריה: ביין, המודל היה מוכן לשלם אותו מחיר על כל כוס נוספת. ובגרסה המעודכנת של המאמר (MSI, 2025) החוקרים מראים שכשמאמנים את המודל על נתוני סקרים קודמים מהקשר דומה, ההתאמה לתשובות של בני אדם משתפרת. אבל שימו לב למה שלא השתפר: קטגוריות מוצר חדשות לגמרי, וההבדלים בין פלחי לקוחות. כלומר בדיוק השאלות שמעצבי מוצר שואלים הכי הרבה.
הכנה למחקר
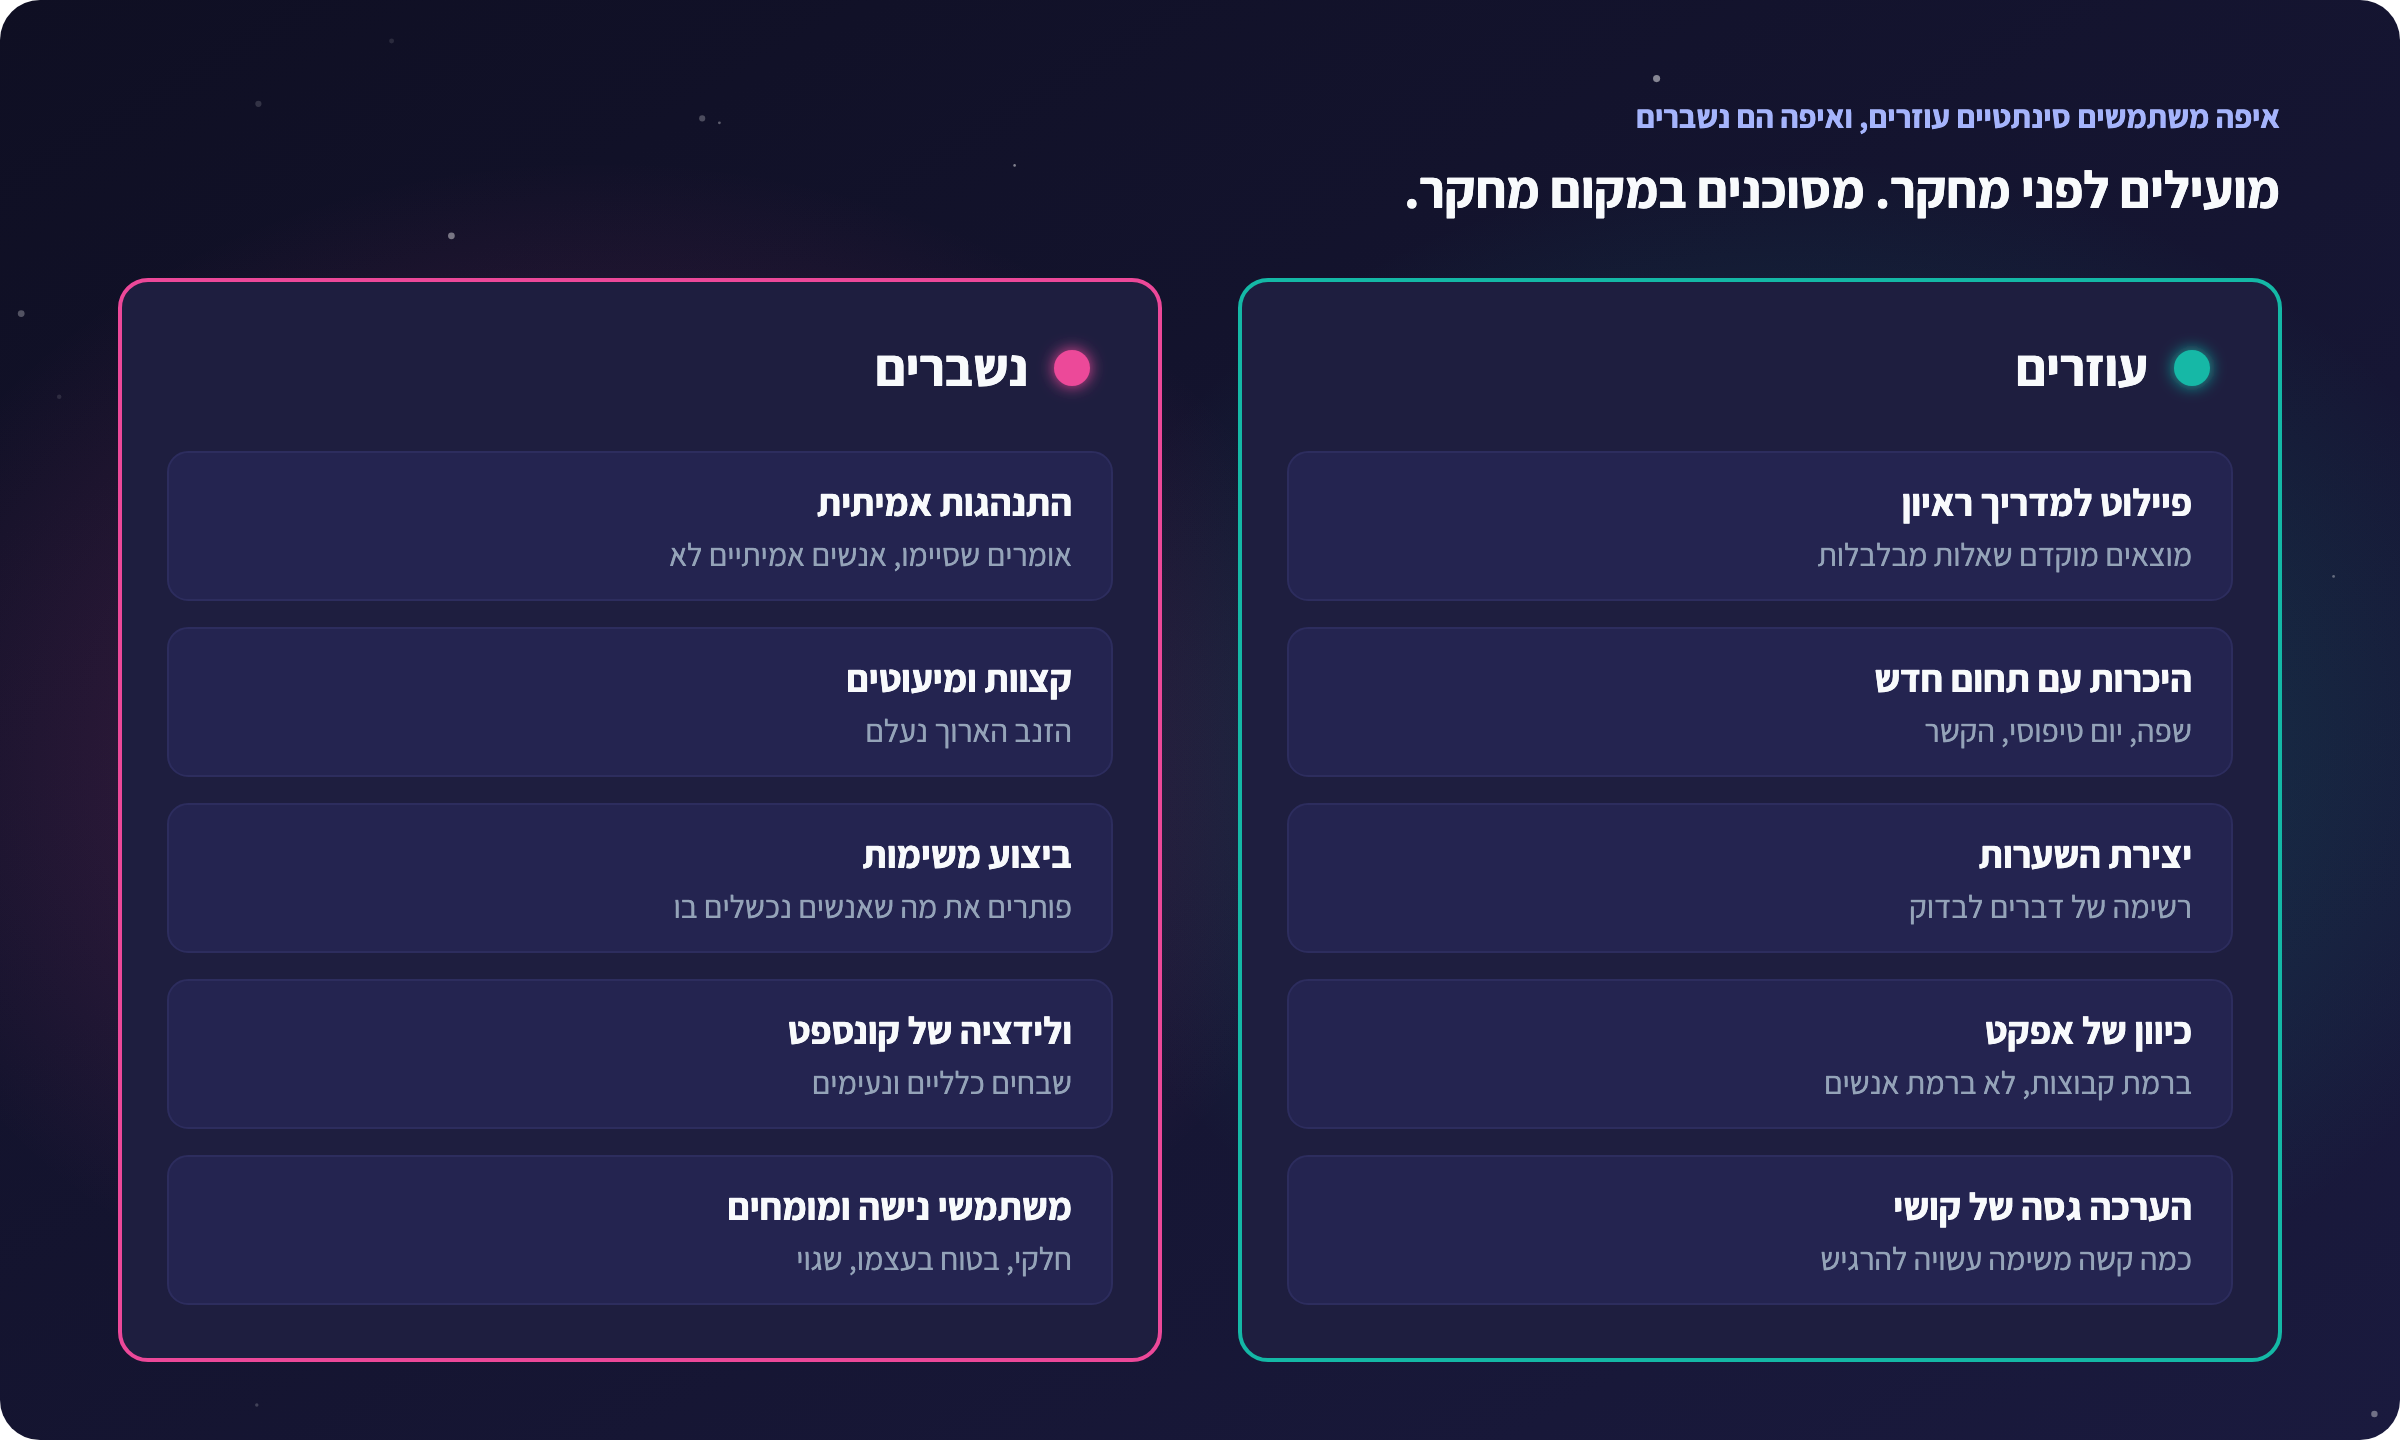
הניסוי של NN/g מ-2024 מצא מקום אחד שבו המשתמש הסינתטי ממש עזר: תיאור של יום עבודה טיפוסי של נציגה רפואית יצא דומה מאוד למה שתיארו המשתמשים האמיתיים. ההמלצה שלהם בהתאם: להשתמש בזה כדי להכיר קהל חדש, או כדי לעשות פיילוט למדריך הראיון לפני שיוצאים לשטח.
זה גם המקום שבו אני הכי אוהב את הכלי, ובדיוק כך אנחנו עובדים איתו בסדנת AI for UX: משתמש סינתטי כשלב הכנה לפני השטח, ולא במקומו.
איפה זה נשבר
כאן נמצא רוב הסיפור, וזה החלק שהכי חשוב לקרוא לפני שמתחילים.
אומרים, לא עושים
הניסוי של Rosala ו-Moran ב-NN/g לקח שלושה מחקרים שכבר נעשו עם אנשים אמיתיים, והריץ אותם שוב עם משתמשים סינתטיים. במחקר על קורסים מקוונים, הלומדים האמיתיים סיפרו שהם מתחילים קורסים ולא מסיימים אותם. המשתמשים הסינתטיים, כששאלו אותם, טענו שסיימו את כל הקורסים. הלומדים האמיתיים כמעט לא השתמשו בפורומים של הקורס, כי השיחות שם הרגישו להם מלאכותיות. המשתמשים הסינתטיים תיארו את הפורומים כחשובים.
זו הבעיה הבסיסית ביותר: למשתמש סינתטי אין התנהגות. יש לו תיאור של התנהגות, והתיאור הזה נוטה לגרסה המסודרת והמחמיאה.
חנפנות מובנית
באותו ניסוי, כשהציגו למשתמש הסינתטי קונספט של משלוח דגימות רפואיות ברחפן, הוא הגיב באהדה ובמשוב כללי. NN/g מייחסים את זה לנטייה של המודל לרצות. זה לא מקרי: מחקר של Anthropic מצא שחמישה עוזרי AI מובילים מפגינים חנפנות באופן עקבי, ושחלק מהסיבה הוא שבני אדם, בנתוני ההעדפות שעליהם המודלים מאומנים, נוטים להעדיף תשובות שמסכימות איתם. כלומר המודל אומן, בין היתר, להגיד לכם מה שאתם רוצים לשמוע. וזה בדיוק ההפך ממה שמחקר משתמשים אמור לעשות.
קריסה לממוצע
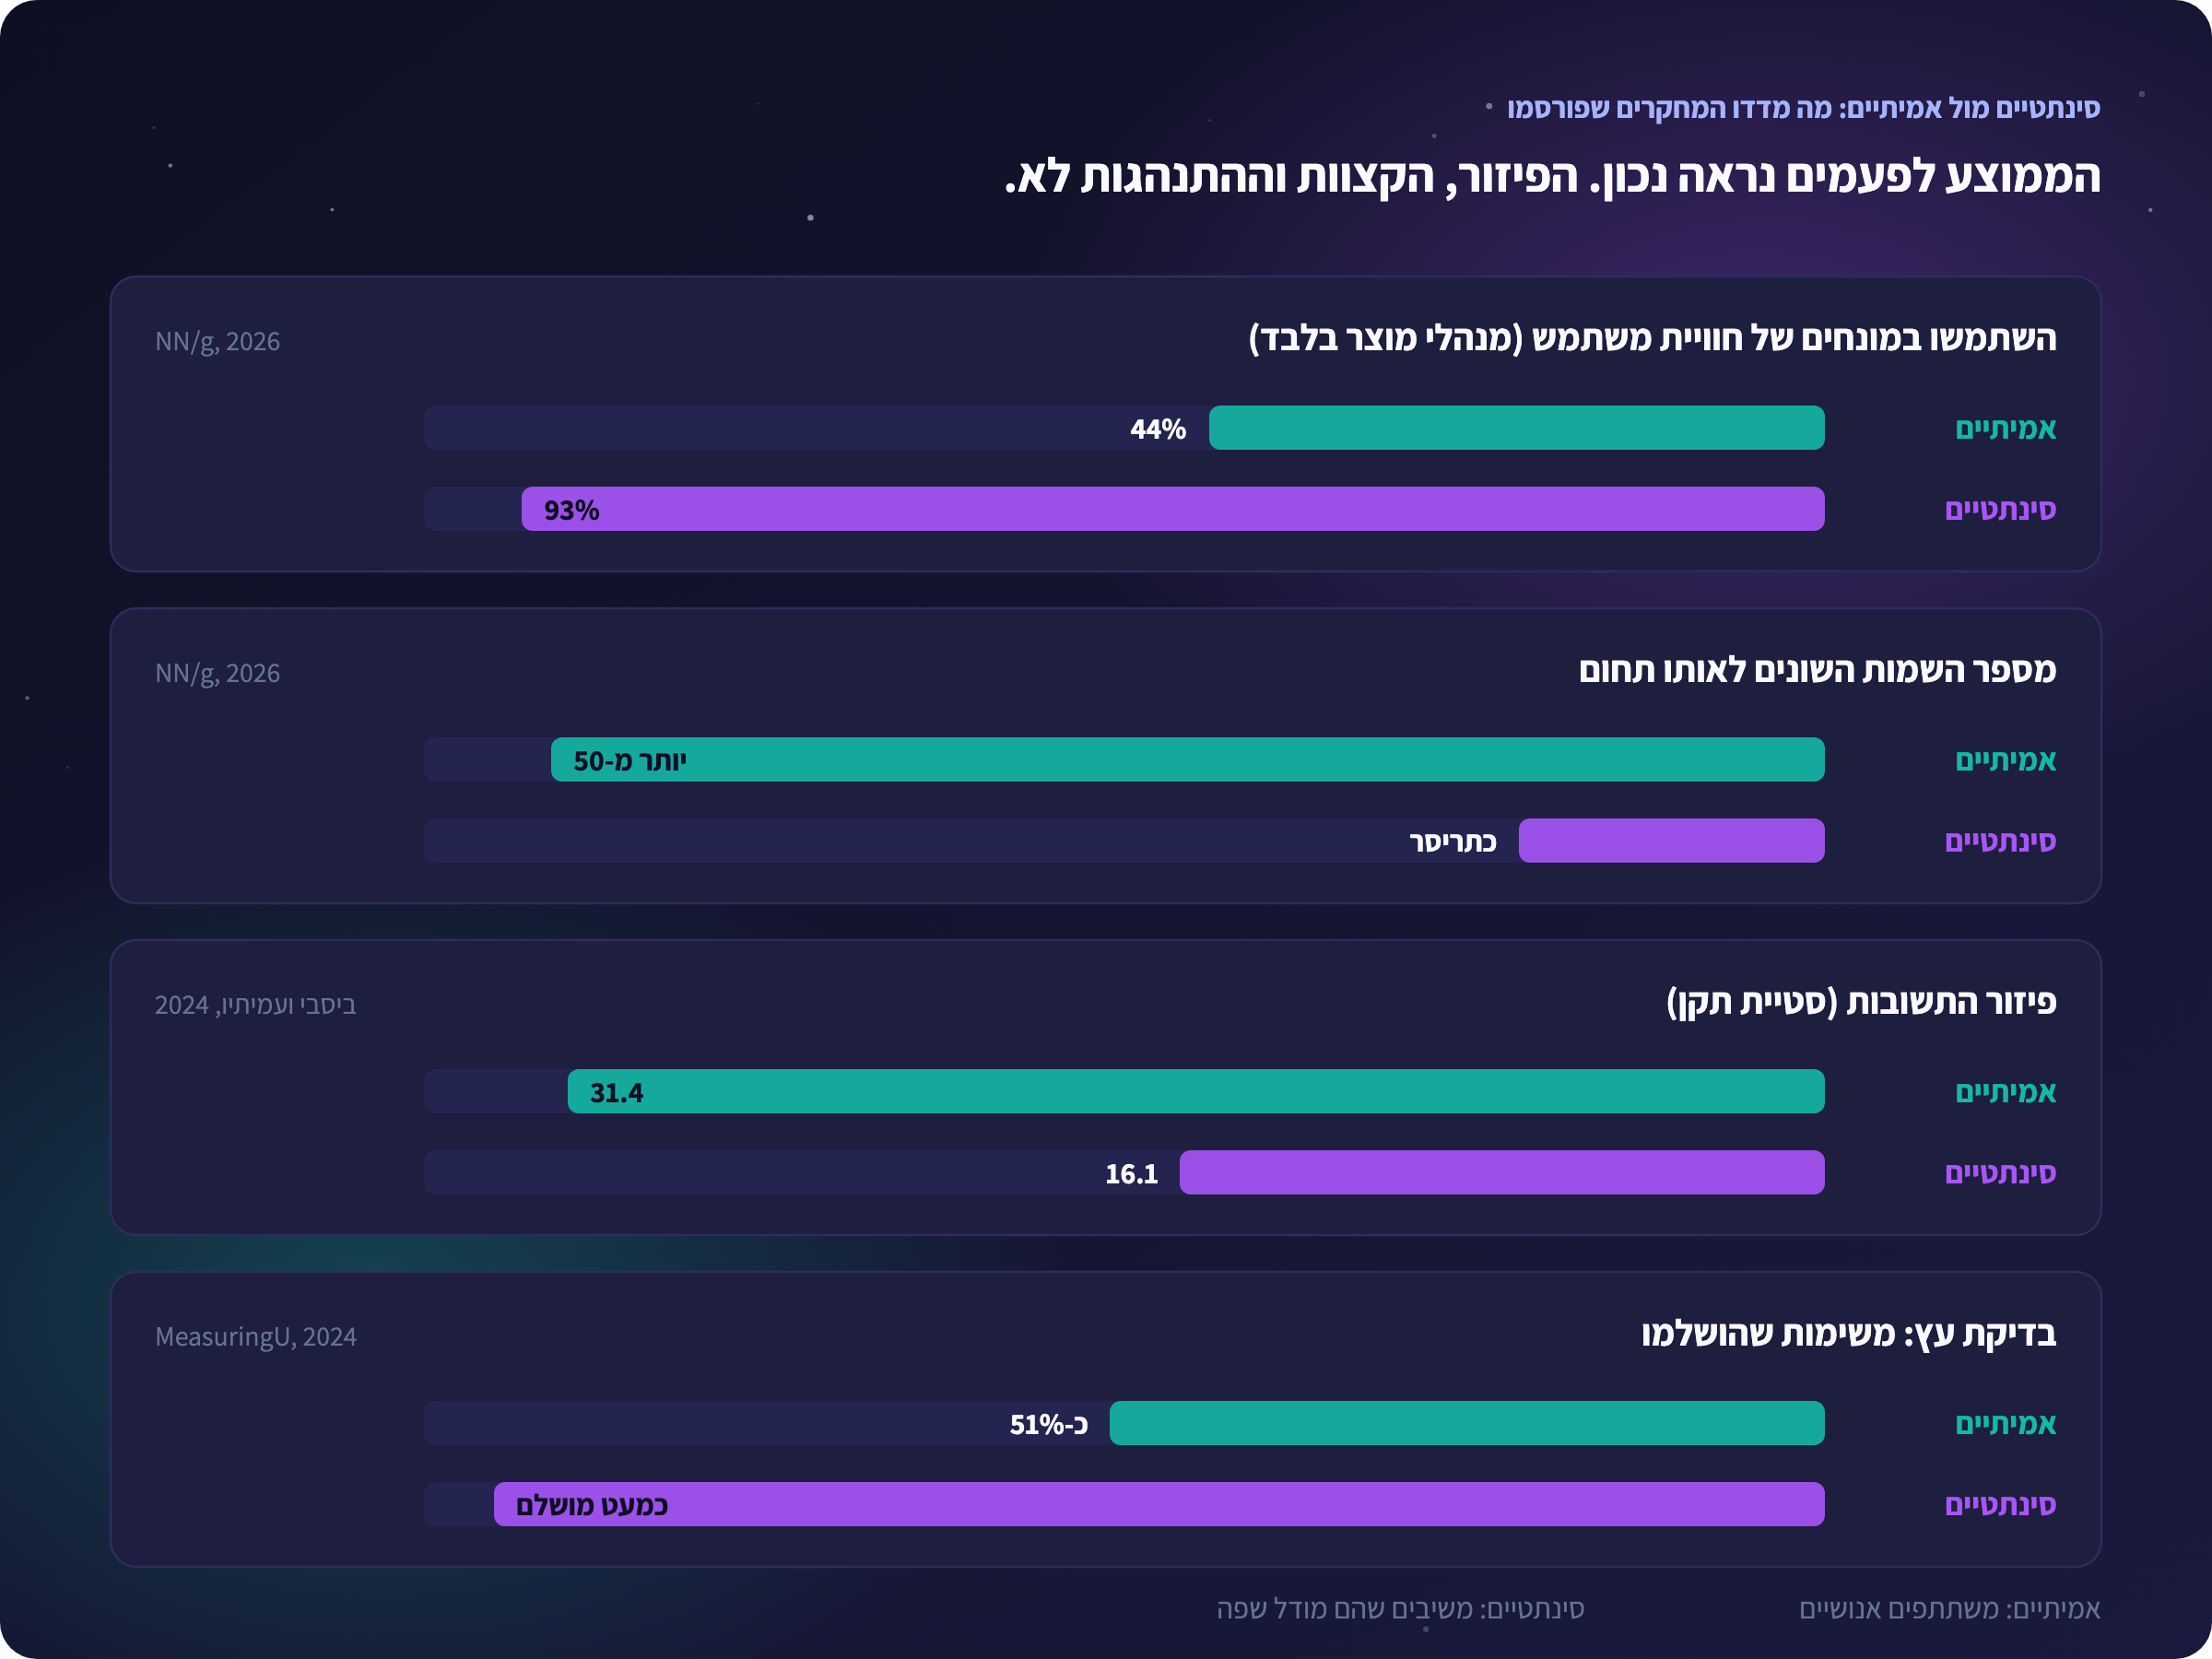
בניסוי של NN/g מאוקטובר 2026, רייצ'ל בנאווה השוותה 604 אנשי מקצוע אמיתיים ל-120 משיבים סינתטיים, על שאלה פתוחה אחת: איך קוראים לתחום שהופך תובנות על משתמשים להמלצות מוצר. בממוצע, שתי הקבוצות הגיעו לאותה מסקנה ("UX"). אבל האנשים האמיתיים השתמשו ביותר מ-50 שמות שונים, והסינתטיים התכנסו לכתריסר. בקרב מנהלי מוצר, 93% מהסינתטיים השתמשו במונחי UX, לעומת 44% מהאמיתיים.
ניתוח של Bisbee ועמיתיו מצא את אותו דפוס בסקרים: הממוצעים של המודל היו קרובים לממוצעים האמיתיים, אבל סטיית התקן הייתה בערך חצי (16.1 לעומת 31.4). כ-48% מהמקדמים ברגרסיות היו שונים באופן מובהק מאלה של הנתונים האמיתיים, ובכשליש מהם הכיוון התהפך.
טוב מדי בשביל להיות אמיתי
ב-MeasuringU בדקו אם ChatGPT יכול להחליף משתתפים בבדיקת עץ (Tree Test). המשתתפים האמיתיים הצליחו בממוצע בכ-51% מהמשימות, ו-ChatGPT מצא כמעט תמיד את הנתיב הנכון. המסקנה של החוקרים הייתה חד-משמעית: זה לא מתאים להערכת היכולת של אנשים למצוא דברים. Aher, Arriaga ו-Kalai קראו לתופעה הזו "עיוות של דיוק-יתר": המודל עונה מדויק יותר ממה שבני אדם עונים, ולכן לא מדמה אותם.
קול אחיד, בלי היסוס
בסטודיו stby השוו פרויקט אמיתי על שימוש ב-AI בעבודה עם גרסה סינתטית של שישה משתתפים (stby, 2024). הנושאים יצאו דומים. מה שחסר היה כל מה שחוקר מחפש בין השורות: אי-ודאות, שינוי עמדה באמצע השיחה, סיפור של מקרה ספציפי. המשתתפים הסינתטיים היו רהוטים, עקביים וממוקדי פתרון, כלומר נוחים לסיכום וחסרי ערך דווקא במקום שבו ראיון עומק אמור להפתיע.
גם תאומים לא מספיקים
הניסוי הגדול ביותר שמצאתי על תאומים דיגיטליים הוא של Peng, Toubia ו-21 חוקרים נוספים, בהובלת אוניברסיטת קולומביה. כל תאום נבנה מתשובות של אדם אמיתי ליותר מ-500 שאלות, ואז נבדק ב-19 מחקרים עם 164 מדדים. התאומים חזו רק מעט טוב יותר מהמודל הבסיסי, והמתאם הממוצע שלהם עם התשובות האמיתיות היה 0.20. החוקרים מנו חמישה עיוותים קבועים: חוסר אינדיבידואליות, סטריאוטיפים, הטיית ייצוג, הטיה אידאולוגית ורציונליות-יתר.
סטריאוטיפים על קבוצות
Wang, Morgenstern ו-Dickerson (המאמר התקבל לפרסום ב-Nature Machine Intelligence) השוו ארבעה מודלים לתשובות של 3,200 משתתפים מ-16 זהויות דמוגרפיות. הם מצאו שהמודלים נוטים לתאר קבוצה כפי שזרים רואים אותה ולא כפי שהיא רואה את עצמה, ומייצרים פחות מגוון תשובות מבני אדם בכל הקבוצות. טכניקות תיקון הפחיתו את הבעיה, אבל לא העלימו אותה.
אותו פרומפט, תשובה אחרת
בניתוח של Bisbee ועמיתיו הריצו את אותו פרומפט בדיוק באפריל, ביוני וביולי 2023, וקיבלו תוצאות שונות. ביולי נרשמה תזוזה משמעותית, שהחוקרים קושרים לעדכון של המודל ב-25 ביוני 2023. במילים אחרות: מחקר סינתטי שהרצתם החודש לא בהכרח ישוחזר בחודש הבא, ואין לכם שליטה על זה.
ממה להיזהר
אם אני מסכם את כל המחקרים לרשימת אזהרות אחת, זו הרשימה שהייתי תולה ליד המסך:
- חנפנות. המודל אומן לרצות, ולכן כמעט כל קונספט יקבל "זה נשמע מעניין".
- מיצוע. התשובה הנפוצה שורדת, הזנב הארוך נעלם. ובמחקר משתמשים, הזנב הוא לעיתים קרובות כל הסיפור.
- בלי התנהגות. המודל מתאר מה אנשים "אמורים" לעשות, לא מה הם עושים. פער האמירה והעשייה, שקיים גם אצל בני אדם, מתרחב.
- ביטחון-יתר. תשובות רהוטות, עקביות וחד-משמעיות. בדיוק מה שגורם לצוות להאמין להן.
- הטיות וסטריאוטיפים. קבוצות מתוארות מבחוץ, וקבוצות נישה מקבלות תשובות חלקיות שנשמעות בטוחות.
- חוסר יציבות. עדכון של המודל יכול לשנות את התוצאות בלי שתדעו.
- זליגה למצגת. ציטוט סינתטי שנכנס לשקף בלי תווית הופך תוך שבוע ל"המשתמשים אמרו".
"Research with synthetic users is still not user research."
אז איך עושים נכון?
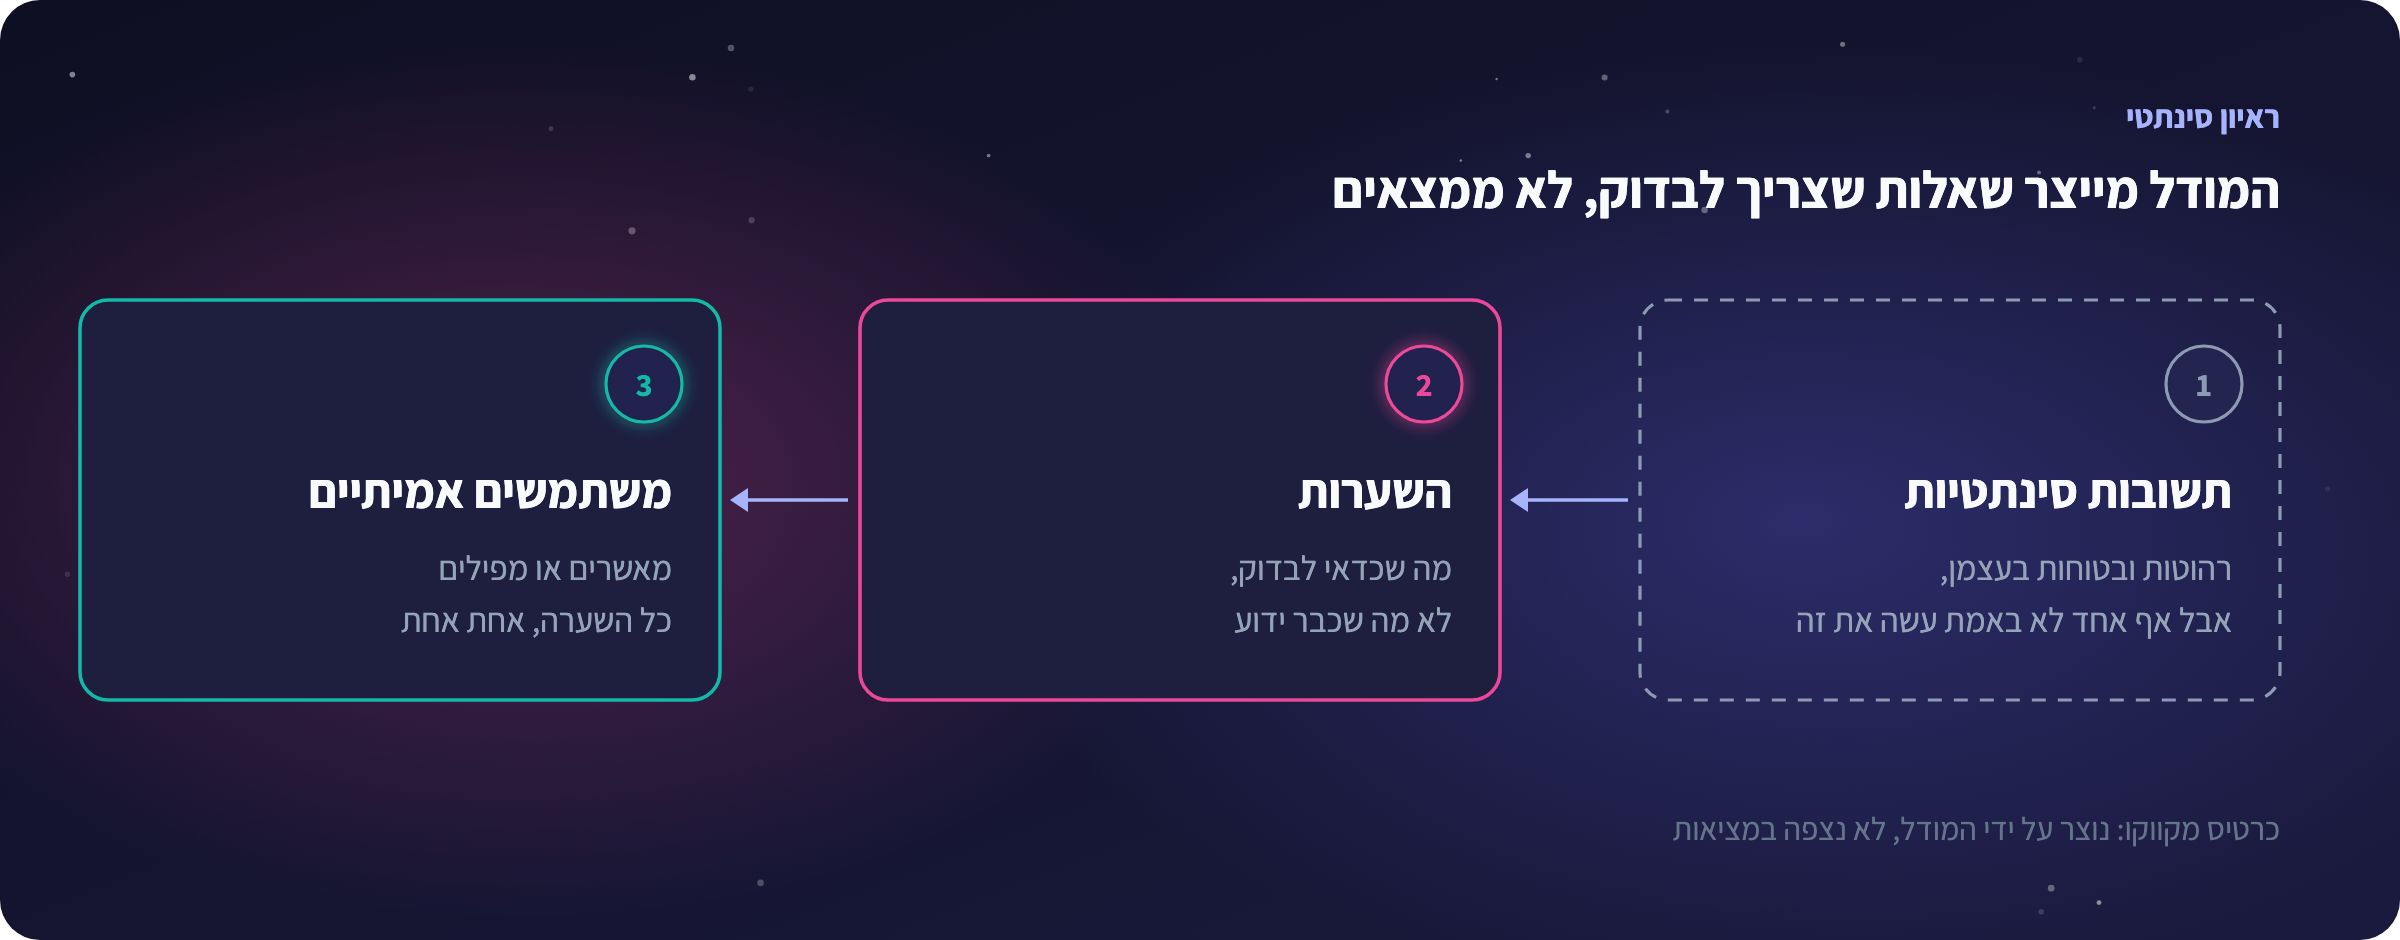
אני לא חושב שהתשובה היא לוותר על הכלי. אני חושב שהתשובה היא לשנות את מה שמצפים ממנו. משתמש סינתטי הוא מכונת השערות, לא מקור אמת. התוצר שלו הוא רשימת שאלות שצריך לקחת לשטח, לא ממצאים.
מהמחקרים עולים כמה עקרונות פשוטים, שכדאי לזכור בכל פעם שפותחים שיחה כזו:
- לקרוא את התשובות כהשערות. כל משפט שהמודל אומר הוא ניחוש מושכל על מה שאנשים אולי חושבים. הוא נקודת פתיחה לשאלה, לא תשובה עליה.
- לחקור, לא להחליט. הכרת תחום חדש, ניסוח שאלות טובות יותר, פיילוט למדריך ראיון. לא לתעדף פיצ'רים, לא לבחור בין קונספטים ולא לקבוע מחיר.
- לחשוד דווקא כשמחמיאים. המודל נוטה לרצות. אם התשובה מסכימה עם מה שקיוויתם לשמוע, זה הרגע להיות הכי חשדנים, לא הכי מרוצים.
- לשים לב למה שחסר. התשובות נוטות להתכנס לממוצע, ולכן הקצוות, המיעוטים והמשתמש החריג שמשנה את התמונה כמעט אף פעם לא יופיעו. מה שלא שמעתם מהמודל לא אומר שהוא לא קיים.
- להיות כנים לגבי המקור. מה שהמודל אמר הוא לא "המשתמשים אמרו", לא בשיחה עם הצוות ולא בשקף ללקוח.
- לאמת עם אנשים. כל השערה שעומדת להשפיע על החלטה חוזרת לבדיקה מול משתמשים אמיתיים, בלי יוצא מן הכלל.
העקרונות האלה מספיקים כדי לא ליפול בפח. לעבוד עם משתמשים סינתטיים כך שהם באמת מייצרים השערות ששוות בדיקה, זה כבר תהליך עבודה שלם, ואותו אנחנו מתרגלים במודול המחקר של סדנת AI for UX, מקצה לקצה ועל פרויקט אמיתי.
סיכום
- מה זה: מודל שפה שעונה כאילו הוא משתתף במחקר, מראיון פרסונה ועד תאום דיגיטלי שנבנה מנתונים של אדם אמיתי.
- איפה זה עובד: הכנה למחקר, הכרת תחום חדש, פיילוט למדריך ראיון, והערכת כיוון של אפקט ברמת אוכלוסייה.
- איפה זה נשבר: התנהגות אמיתית, קצוות ומיעוטים, ביצוע משימות, ולידציה של קונספטים וקהלי נישה.
- ממה להיזהר: חנפנות, מיצוע, ביטחון-יתר, סטריאוטיפים, חוסר יציבות וציטוטים שזולגים למצגת.
- העצה שלי: להשתמש בזה כדי להגיע לראיון האמיתי עם שאלות טובות יותר, אף פעם לא במקומו.
רוצים ללמוד לעבוד עם משתמשים סינתטיים נכון, משאלת המחקר ועד רשימת השערות שאפשר לקחת לשטח? להרשמה לסדנת AI for UX
אהבתם את הפוסט? אולי תאהבו גם את הפייסבוק, הטיק טוק, האינסטגרם שלנו. אנחנו מעלים טיפים יומיים על נושאים שמרגשים אותנו.